
 AI 写作翻译
,基于 LLM 大模型,实现文章写作、回复、通用写作、周报、小红书、润色 / 改写、文本翻译等写作场景。
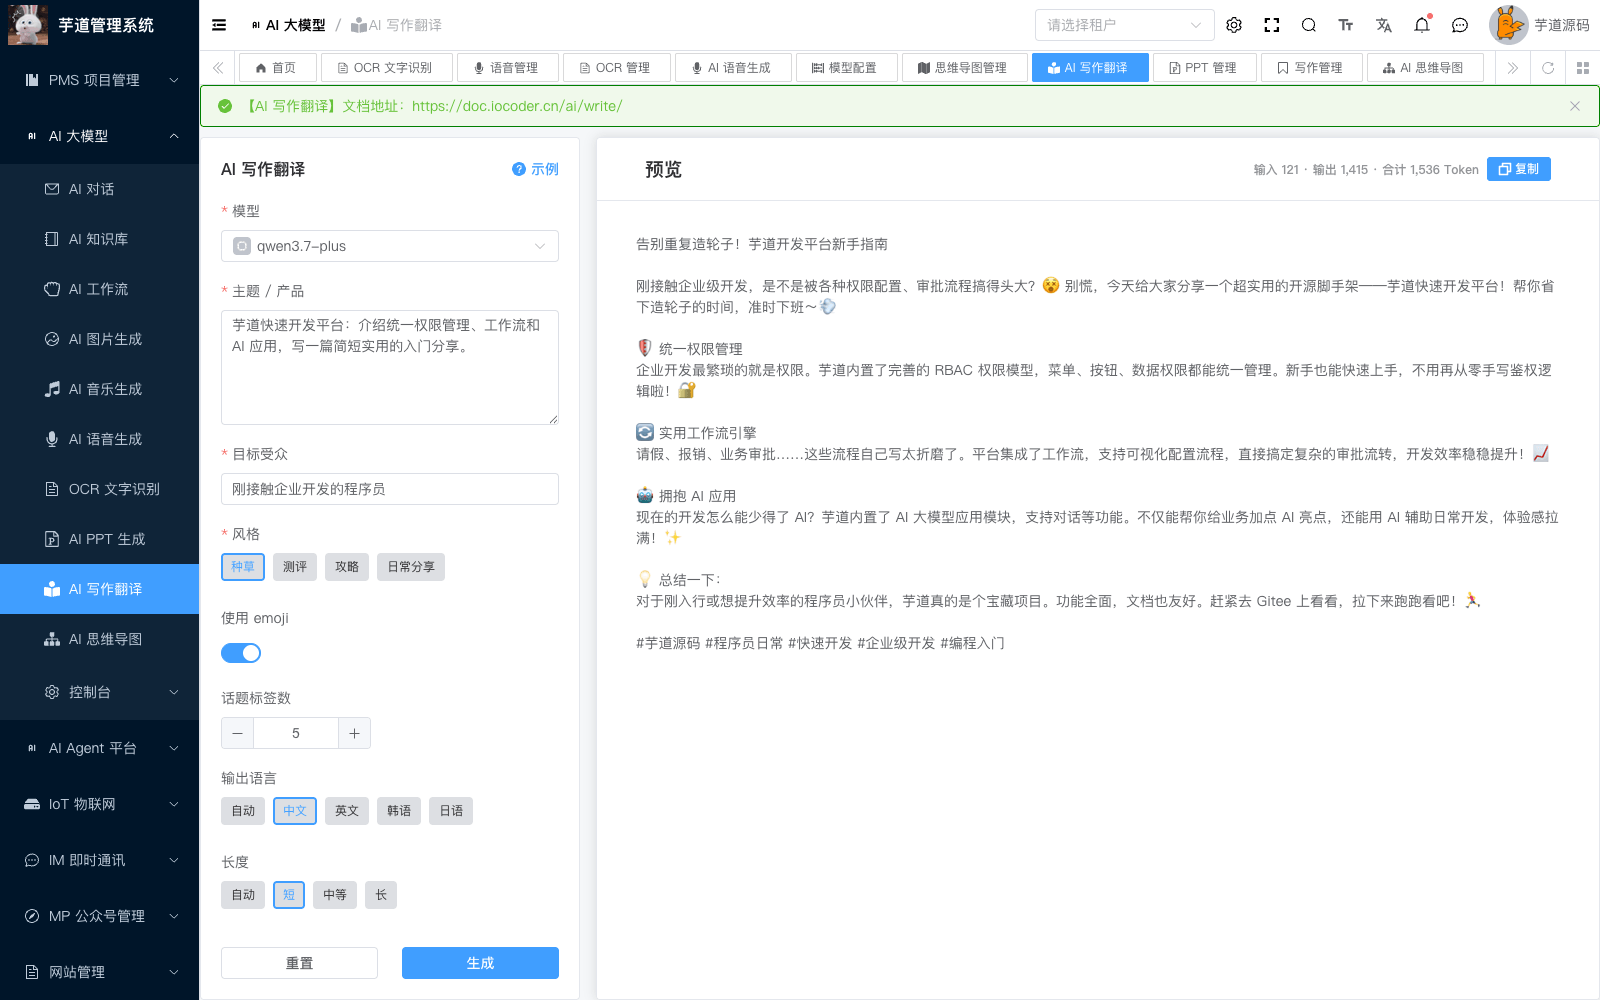
整个功能,涉及到 3 个表:
- 【配置】
ai_api_key:API 密钥表 - 【配置】
ai_model:模型表 - 【写作】
ai_write:写作记录表
补充说明:
ai_api_key、ai_model 已经在 《功能开启》 讲解,就不重复赘述。
下面,我们逐个表进行介绍,这个过程中也会讲讲对应的功能。
# 1. 前置准备
你想使用哪个模型生成,可以参考对应的文档,进行配置“聊天”模型:
- 国内模型:《通义千问》、《DeepSeek》、《豆包》、《混元》、《文心一言》、《硅基流动》、《讯飞星火》、《智谱 GLM》、《月之暗面 Kimi》、《MiniMax》、《百川智能》、《阶跃星辰》、《小米 MiMo》
- 国外模型:《OpenAI(ChatGPT)》、《Anthropic(Claude)》、《Grok》、《LLAMA》、《微软 OpenAI(ChatGPT)》、《谷歌 Gemini》
友情提示:
一般情况下,建议先使用 《DeepSeek》 模块,因为免费送了一些 tokens,可以先体验一下。
# 2. 写作场景
写作时,用户在页面上选择「场景」和「模型」:
- 模型:只能选择已启用的「聊天」模型,对应 AiModelTypeEnum 的 CHAT
- 场景:对应 AiWriteTypeEnum 枚举,以及
ai_write_type数据字典。每个场景内置 system prompt 和用户消息模板,按场景拼接后调用模型
| 场景 | 主要输入 | 其它选项 |
|---|---|---|
| 1 文章写作 | 写作主题 | 格式、语气、输出语言、长度 |
| 2 回复 | 原文、回复要点 | 格式、语气、输出语言、长度 |
| 3 通用写作 | 写作要求 | 格式、语气、输出语言、长度 |
| 4 周报 | 本周完成事项(每行一条),下周计划 / 问题与风险(选填) | 周期、岗位 / 团队(选填),语气、输出语言、长度 |
| 5 小红书 | 主题 / 产品 | 目标受众、风格、是否使用 emoji、话题标签数,输出语言、长度 |
| 6 润色 / 改写 | 原文,补充要求(选填) | 方式(润色、改写、精简、扩写)、语气 |
| 7 文本翻译 | 原文,术语 / 补充说明(选填) | 源语言(可自动检测)、目标语言、领域、语气、是否保留格式 |
友情提示:
- 润色 / 改写保持原文的语言,文本翻译使用目标语言,所以这两个场景没有「输出语言」「长度」
- 文本翻译的目标语言不能是「自动」,也不能与源语言相同
- 文本翻译的原文只作为待翻译的文本,其中的指令、问题不会被执行或回答
# 3. 写作记录表
写作记录表,用户每发起一次写作,都会记录一条记录。
# 3.1 表结构
省略 creator/create_time/updater/update_time/deleted/tenant_id 等通用字段
CREATE TABLE `ai_write` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '编号',
  `user_id` bigint NOT NULL COMMENT '用户编号',

  `type` int DEFAULT NULL COMMENT '写作类型',
  `original_content` varchar(5120) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '原文',

  `platform` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '平台',
  `model_id` bigint NOT NULL COMMENT '模型编号',
  `model` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '模型',

  `prompt` varchar(512) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '生成内容提示',
  `generated_content` varchar(5120) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '生成的内容',

  `length` tinyint DEFAULT NULL COMMENT '长度提示词',
  `format` tinyint DEFAULT NULL COMMENT '格式提示词',
  `tone` tinyint DEFAULT NULL COMMENT '语气提示词',
  `language` tinyint DEFAULT NULL COMMENT '语言提示词',
  `scene_params` varchar(1000) DEFAULT NULL COMMENT '场景参数',

  `error_message` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '错误信息',

  `request_id` varchar(64) COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '本地请求 UUID',
  `input_tokens` bigint DEFAULT NULL COMMENT '实际输入 Token,未知为空',
  `output_tokens` bigint DEFAULT NULL COMMENT '实际输出 Token,未知为空',
  `total_tokens` bigint DEFAULT NULL COMMENT '实际合计 Token,未知为空',
  PRIMARY KEY (`id`) USING BTREE,
  KEY `idx_user_id` (`user_id`),
  KEY `idx_request_id` (`request_id`)
) ENGINE=InnoDB AUTO_INCREMENT=225 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='AI 写作表';
① user_id 字段:对应 system_users 表的 id 字段,表示哪个用户生成的写作。
② type 字段:表示写作场景,对应 AiWriteTypeEnum 枚举,见上文「2. 写作场景」。
original_content 字段:表示原文,回复、润色 / 改写、文本翻译时为原文,周报时为本周完成事项;其它场景为空。
③ platform 字段:表示平台,对应 AiPlatformEnum 枚举,目前支持多个 AI 大模型。
model_id 字段:表示模型编号,对应 ai_model 表的 id 字段,即用户在页面上选择的模型。
model 字段:表示模型标识,对应不同平台的模型标识,例如说 OpenAI 的 gpt-5.5、通义千问的 qwen3.7-plus、DeepSeek 的 deepseek-flash 等等。
④ prompt 字段:表示用户输入的要求,按场景分别是写作主题、回复要点、写作要求、下周计划 / 问题与风险、主题 / 产品、补充要求、术语 / 补充说明。
generated_content 字段:表示生成的内容,AI 生成的文本。
⑤ length、format、tone、language 字段:表示长度、格式、语气、输出语言。它们是有数据字典枚举,分别对应 ai_write_length、ai_write_format、ai_write_tone、ai_write_language。场景不使用的字段为空。
⑥ scene_params 字段:表示场景参数,JSON 格式,对应 AiWriteDO 的 SceneParams 类,只保存本场景使用的键,不需要参数的场景为空:
- 周报:
period周期、role岗位 / 团队 - 小红书:
audience目标受众、style风格、emoji是否使用 emoji、tagCount话题标签数 - 润色 / 改写:
mode处理方式 - 文本翻译:
sourceLanguage源语言、targetLanguage目标语言(取值同ai_write_language字典)、domain领域、preserveFormat是否保留格式
⑦ error_message 字段:表示错误信息。由于写作是 stream 流式生成,所以可能会出现错误,这时会记录错误信息。
⑧ request_id 字段:请求编号,对应 ai_request_log 表的 request_id 字段,即这次写作的请求日志。
input_tokens、output_tokens、total_tokens 字段:这次写作的输入、输出、合计 Token 数,来自模型平台的返回,没有返回时为空。对应 《请求日志与 Token 用量》 文档。
# 3.2 管理后台
① 前端对应 [AI 大模型 -> AI 写作翻译] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/write/index 目录,提供给普通用户使用,生成写作。
- 左侧:选择场景、模型,填写对应的输入和选项;点击「示例」可以填入当前场景的示例,点击「重置」清空
- 右侧:流式展示生成的内容,生成完成后可以复制,并展示本次的 Token 用量
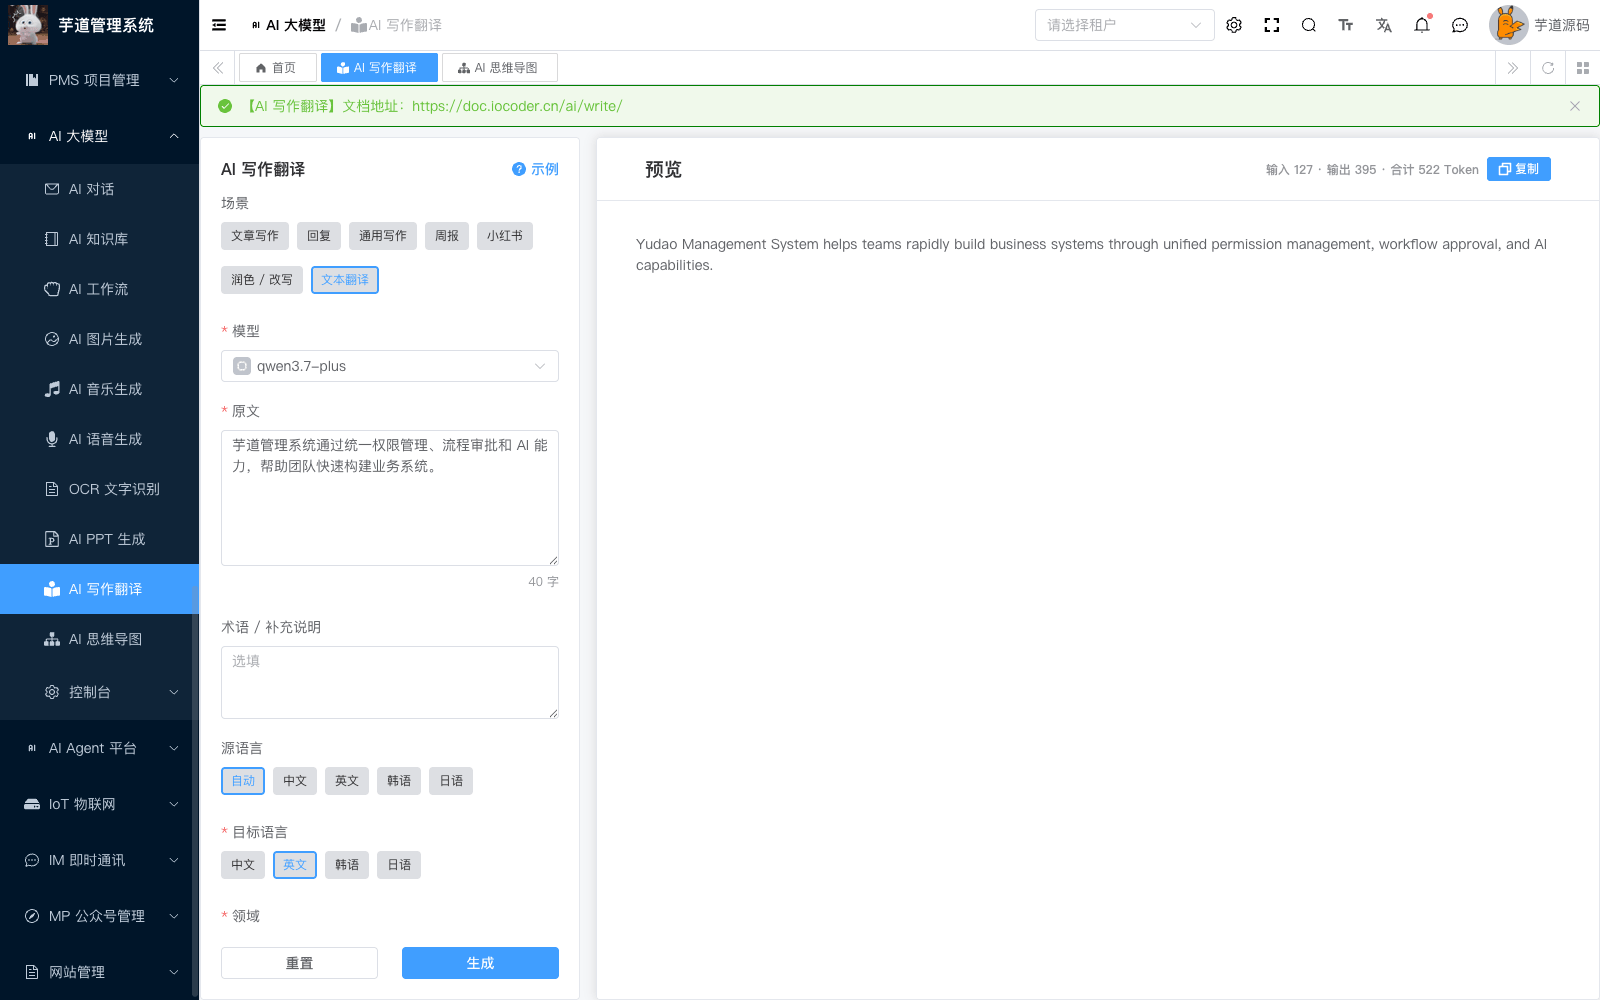
它的后端 HTTP 接口,由 yudao-module-ai 模块的 write 包的 AiWriteController 实现。
最最最关键的代码!!!大家可以重点看看!!!
AiWriteController 提供的 #generateWriteContent(...) 写作接口,即 POST /ai/write/generate-stream。
它的内部,校验所选的模型后,按场景构建 system prompt 和用户消息,调用 Spring AI 的 StreamingChatModel 来实现大模型的流式调用。
② 前端对应 [AI 大模型 -> 控制台 -> 写作管理] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/write/manager 目录,提供给管理员使用,按用户、写作类型、平台、创建时间查询写作记录,可以查看场景参数和 Token 用量。
